
инхронизация Аудио И Анимация Лиц В Мультимедийных Генераторах Видео
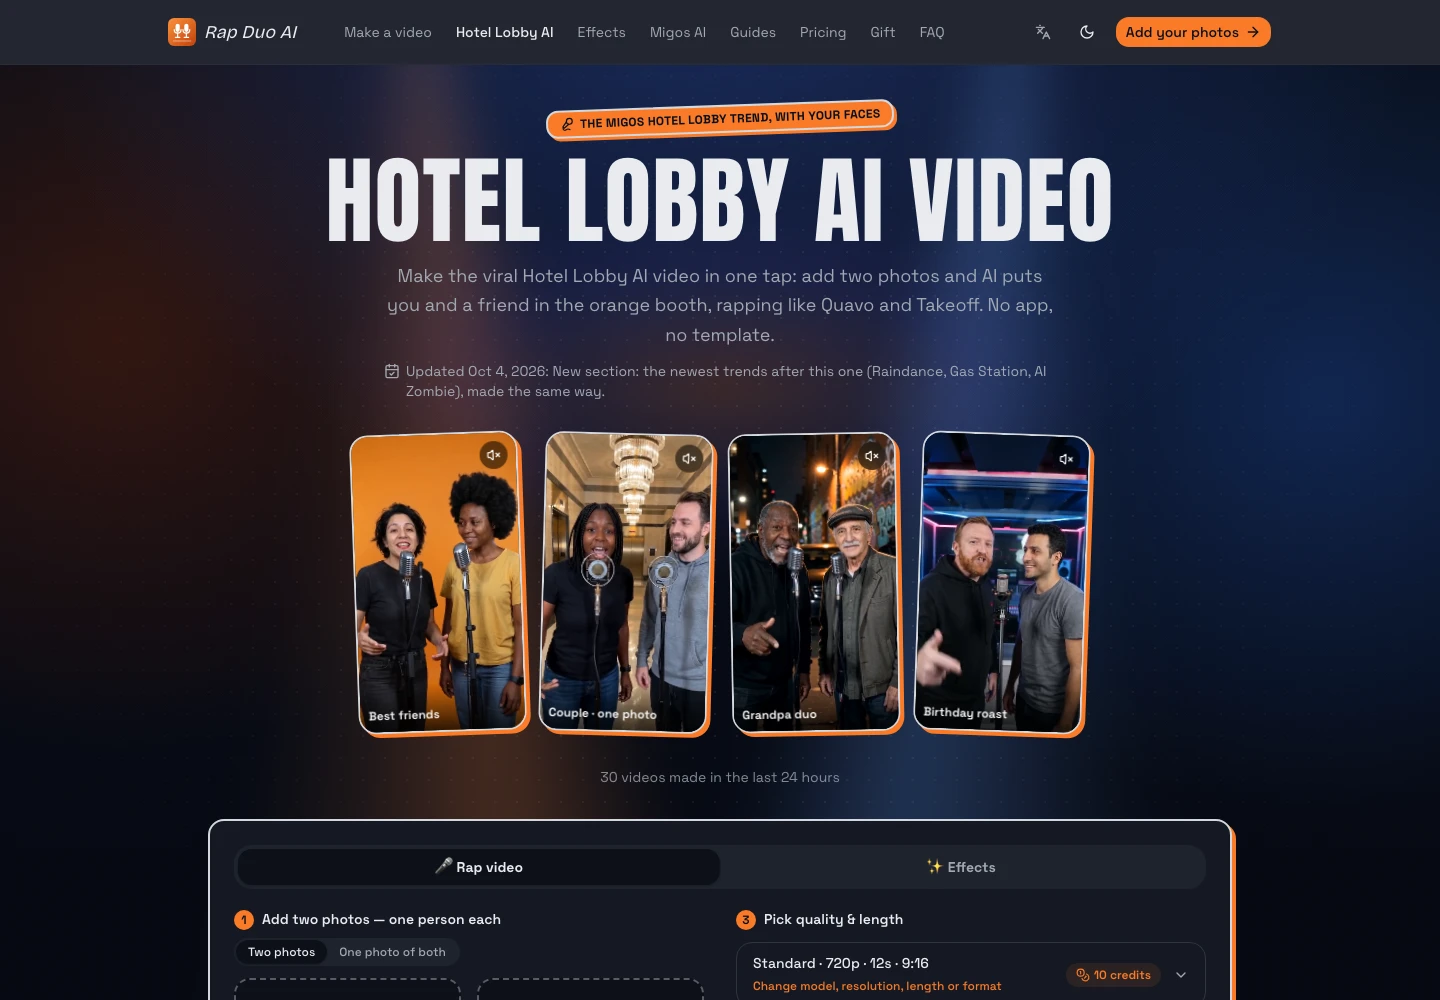
Разработчики мультимедийного контента часто сталкиваются с технической сложностью синхронизации анимации лиц и звуковых дорожек. Применение специализированной платформы Rap Duo AI позволяет быстро преобразовывать две статичные фотографии в согласованный музыкальный видеоролик без необходимости ручного покадрового редактирования.В классическом видеопроизводстве совмещение мимики персонажа с динамичным вокальным треком требует создания детализированных трехмерных моделей, расстановки ключевых кадров и тонкой настройки артикуляционных морфов. Если проект включает двух одновременно выступающих исполнителей, объем вычислительных и временных затрат возрастает экспоненциально. Автоматизированные генеративные системы устраняют эту технологическую преграду, объединяя анализ геометрии лица, генерацию синтетического вокала и процедурную анимацию в единый программный контур.
Архитектурные Ограничения Традиционных Пайплайнов Анимации Речи
Построение реалистичной лицевой анимации традиционными методами опирается на сложный цепочечный процесс. Графическому специалисту необходимо изолировать контуры лица, выделить анатомические маркеры глаз, носа и губ, а затем вручную привязать их к сетке деформации. Любое несоответствие между акустической формантой и положением челюсти мгновенно считывается зрителем как противоестественный сбой, нарушающий восприятие видеоряда.Когда требуется подготовить короткий развлекательный ролик для социальных сетей, использование громоздких пакетов трехмерного моделирования оказывается экономически нецелесообразным. Затраты рабочего времени на анимацию одного короткого куплета могут занимать целый день, а потерянный час на ручной подгонке таймлайна в видеоредакторе лишает команду оперативной реакции на тренды. Интеграция легковесных генеративных алгоритмов позволяет исключить рутинные манипуляции со звуковыми дорожками и сосредоточиться на творческой концепции проекта.
Дополнительная проблема заключается в разрозненности инструментов для звука и видео. В классическом пайплайне звукорежиссер сводит вокал в отдельной программе, экспортирует аудиодорожку, а затем передает ее аниматору. Если темп трека требует корректировки, весь цикл правок приходится повторять заново. Монолитные генеративные платформы устраняют этот разрыв, генерируя аудиодорожку и видеоряд в рамках одного вычислительного графа.
Трудоемкость Ручной Привязки Фонетических Сплайнов К Сетке
Основная сложность ручной анимации заключается в нелинейности человеческой артикуляции. Скорость произнесения согласных звуков в быстром рэп-треке требует точной динамики раскрытия рта. При классическом монтаже аниматор вынужден покадрово выверять положение губ под каждый звуковой всплеск, что неизбежно приводит к накоплению мелких ошибок синхронизации.Алгоритмы прямого нейросетевого синтеза работают по принципу сквозного преобразования аудиосигнала в параметры пространственного смещения пикселей. Обученная модель распознает ритмические паттерны трека и автоматически генерирует естественные мимические движения, сохраняя пластику лица и характерные движения головы персонажа в такт звучащему биту.
Принципы Нейросетевой Синхронизации Двух Персонажей В Кадре
Ключевое отличие специализированных дуэтных генераторов заключается в способности объединять двух независимых субъектов в единое виртуальное пространство сцены. Входными данными служат обычные фотопортреты, которые могут быть сделаны в разных условиях освещения и на разных устройствах. Программный комплекс выполняет сегментацию объектов, нормализует цветовой баланс и встраивает персонажей в выбранное сценическое окружение.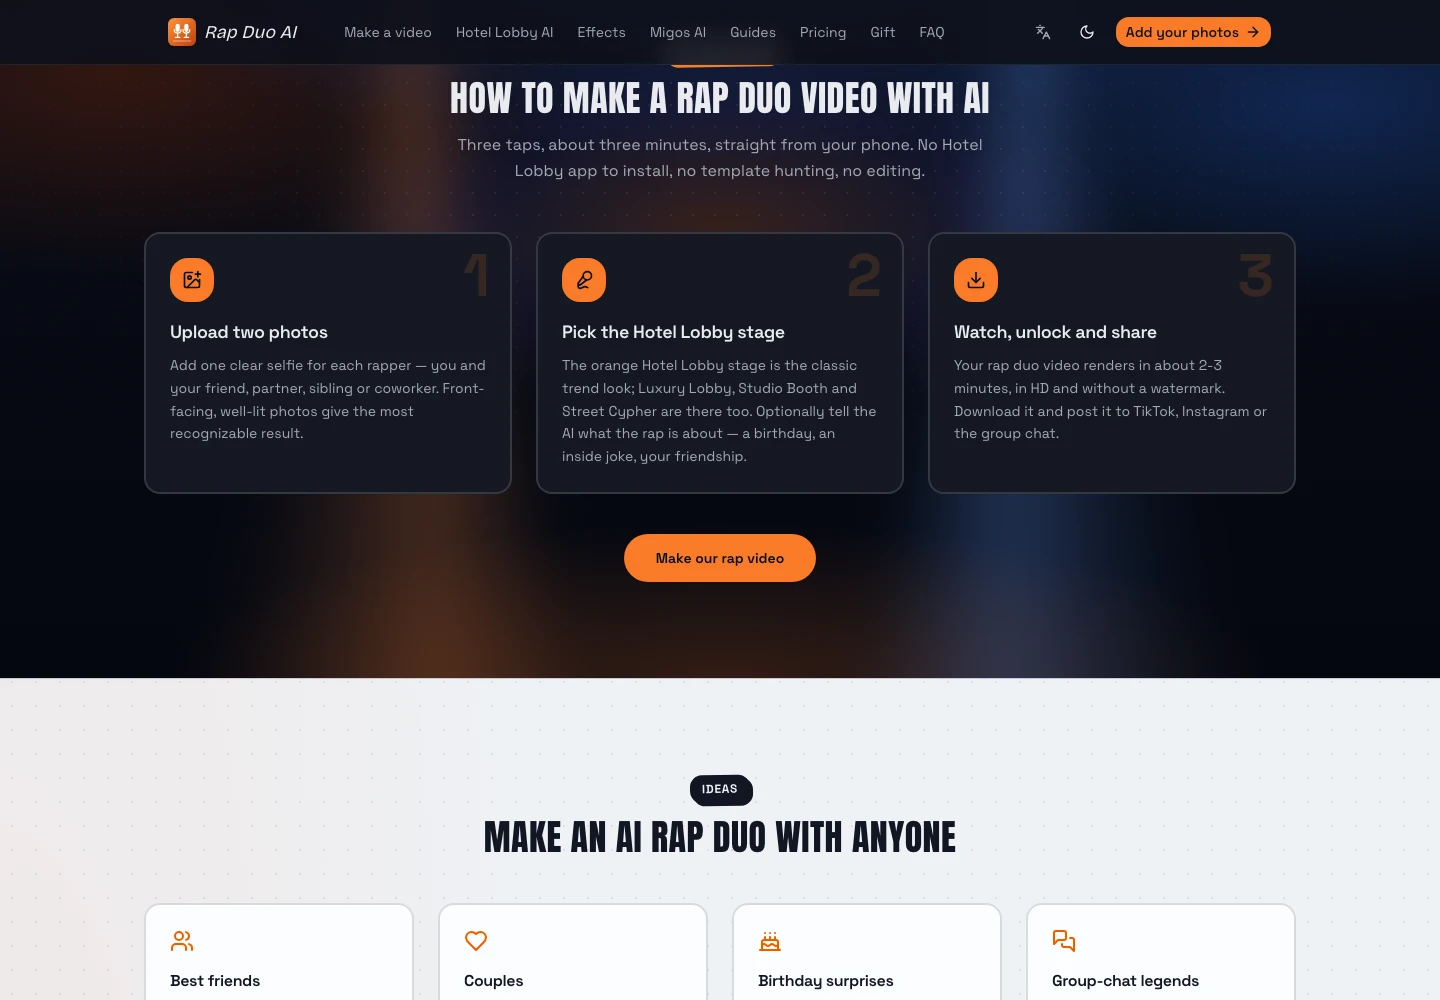
Использование инструмента Rap Duo Video AI открывает доступ к предварительно настроенным окружениям, включая классическую оранжевую сцену Hotel Lobby, студийный бокс и городскую уличную локацию. Система автоматически распределяет вокальные партии, позволяя персонажам поочередно обмениваться рифмованными фразами под синхронизированный музыкальный аккомпанемент.
Анализ Входных Данных И Фиксация Опорных Точек Лица
Перед запуском рендеринга нейросетевой модуль анализирует входные снимки на предмет наличия четких ключевых точек. Программа определяет наклон головы, линию взгляда и форму челюсти, формируя скрытую математическую маску лица. Этот этап является критическим, так как стабильность маски предотвращает дрожание текстур во время быстрых вокальных переходов.Если исходная фотография содержит чрезмерные блики или элементы одежды, закрывающие подбородок, система предупреждает о потенциальных искажениях. Фиксация стабильных опорных узлов гарантирует, что при поворотах головы черты лица не потеряют пропорции, а сгенерированная мимика сохранит анатомическую достоверность.
Генерация Ритмической Структуры И Выбор Окружения Сцены
После распознавания лиц алгоритм приступает к формированию звуковой и анимационной дорожек. Пользователь может задать текстовую тему для композиции, которая определяет смысловую направленность текста и интонационный рисунок. Нейросеть генерирует оригинальные рифмованные строки, подбирает соответствующий темп и накладывает синтезированный голос на инструментальную базу.Сценическое окружение играет роль объединяющего визуального якоря. Выбор фирменного оранжевого фона Hotel Lobby моментально задает динамичный тон ролику, популярный в коротких видеоформатах. Персонажи не просто статично присутствуют в кадре, а активно взаимодействуют с ритмом композиции через скоординированные наклоны корпуса и жестикуляцию.
Инженерный Контроль Качества И Отбраковка Артефактов Рендера
Автоматизированная генерация требует системной проверки готовых медиафайлов перед публикацией. Несмотря на высокую точность нейросетевых моделей, артефакты компрессии исходных снимков могут влиять на четкость финального видеоряда. Контент-редакторам необходимо придерживаться регламента технической оценки каждого сгенерированного ролика.- Оценка резкости контуров губ и точности смыкания рта при произнесении взрывных согласных.
- Проверка стабильности текстуры кожи и отсутствия размытия на границе подбородка и фона.
- Сопоставление общего цветового тона обоих исполнителей с освещением выбранной сцены.
- Контроль ритмического соответствия акцентов текста звуковым долям инструментального бита.
Также проверяется устойчивость взгляда персонажа относительно виртуальной камеры. Если на исходной фотографии субъект смотрел сильно вбок, при фронтальной анимации может возникнуть эффект расфокусировки. Отбор снимков с прямым или слегка полуанфасным ракурсом гарантирует естественный зрительный контакт со зрителем на протяжении всего клипа.
Предотвращение Искажений При Быстром Вокальном Темпе
Особое внимание уделяется фрагментам с высокой плотностью слогов в секунду. В такие моменты нейросеть должна совершать быстрые микропереходы между различными формами губ. Если исходное изображение имело низкое разрешение, модель может сгенерировать легкое замыливание зоны рта.Для устранения подобных артефактов рекомендуется использовать фотографии, сделанные при фронтальном мягком свете без резких теней. В этом случае генератор точно удерживает граничные пиксели, создавая отчетливую артикуляцию даже на самых энергичных отрезках трека.
Экономика Вычислительных Ресурсов И Модели Тарификации
Внедрение генеративных инструментов позволяет кардинально снизить себестоимость производства развлекательного медиаконтента. Аренда звукозаписывающей студии, привлечение дикторов и оплата услуг видеомонтажера формируют высокий порог входа для небольших цифровых команд. Автоматизированные решения переводят эти расходы в формат прозрачной оплаты вычислительных ресурсов.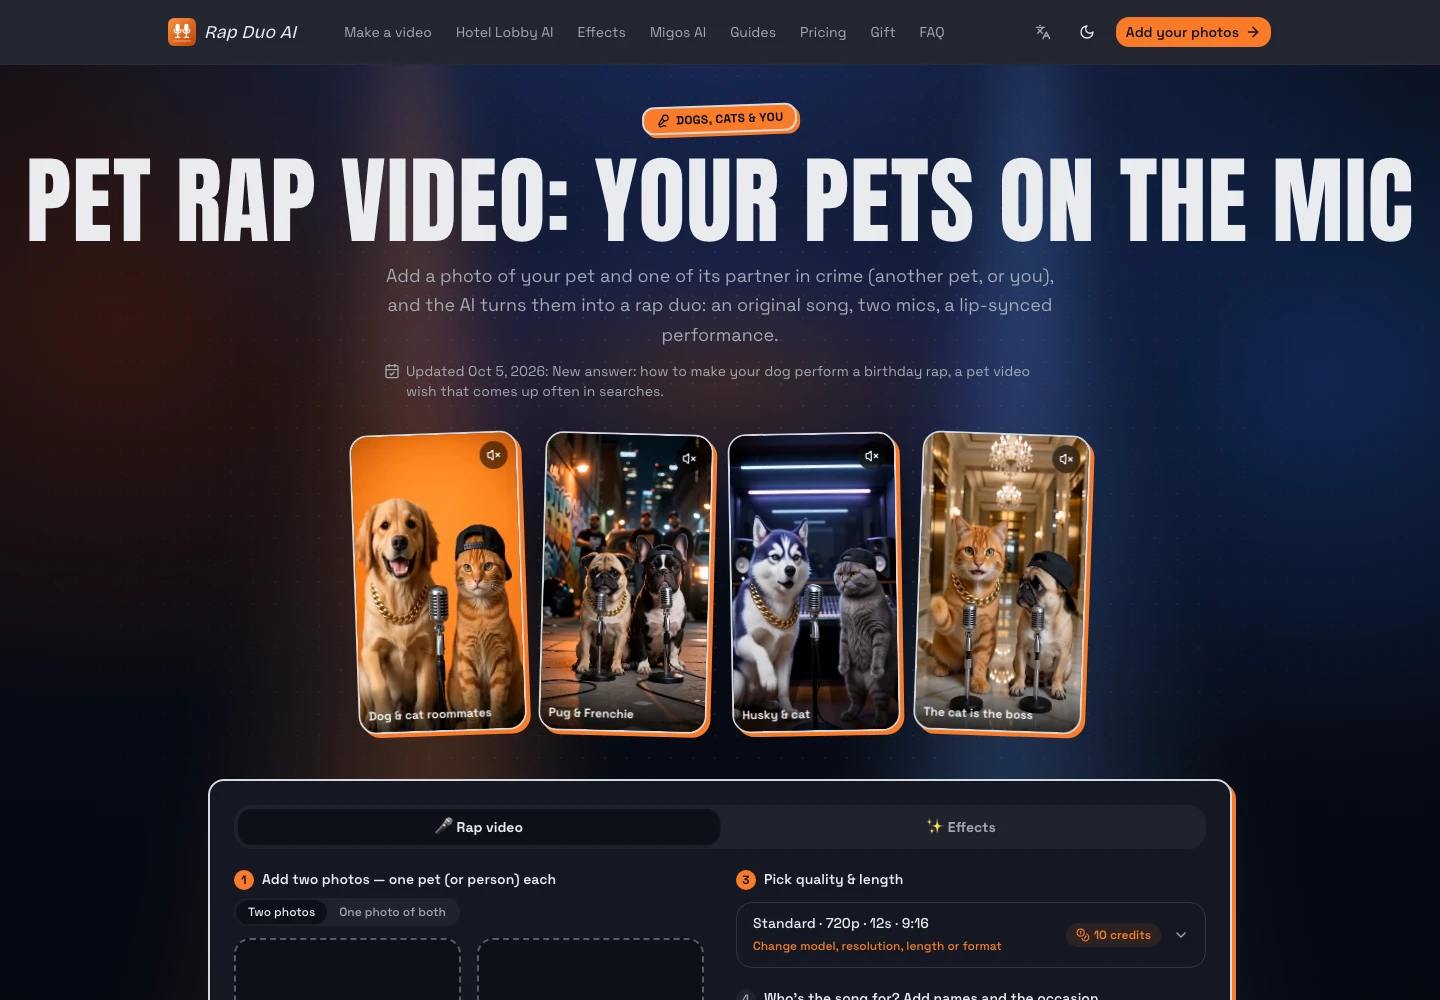
Стандартный двенадцатисекундный видеоклип в разрешении 720p на платформе Rap Duo расходует ровно 10 кредитов. Гибкая тарифная сетка позволяет приобретать разовые пакеты кредитов без обязательной подписки либо подключать ежемесячные планы с дополнительной скидкой на каждый сгенерированный ролик. При этом кредиты из разовых пакетов не имеют срока действия, что удобно для нерегулярных проектов.
Для студий с регулярным объемом выпуска контента подписочные планы обеспечивают стоимость одного готового ролика на уровне полутора-двух долларов. Это позволяет планировать медийные кампании без риска перерасхода бюджета. Возможность точного прогнозирования расходов делает технологию доступной как для индивидуальных блогеров, так и для корпоративных SMM-отделов.
Существенным преимуществом для разработчиков является политика финансовой защиты от программных сбоев. Если процесс генерации прерывается из-за сетевой ошибки или срабатывания защитных фильтров, списанные кредиты в системе Rap Duo мгновенно возвращаются на баланс пользователя. Это исключает финансовые потери при экспериментах со сложными исходными материалами.
Такая прозрачная модель расхода ресурсов выгодно отличает современные генеративные платформы от устаревших сервисов с непрозрачным списанием средств. Команда точно знает, сколько готовых видеороликов можно выпустить в рамках выделенного месячного бюджета, оптимизируя затраты на производство медиа.
Оптимизация Рабочих Процессов В Цифровом Производстве Видео
Автоматизация синтеза медиаконтента открывает новые возможности для цифровых медиа, маркетинговых отделов и независимых создателей видео. Интеграция программных решений Rap Duo устраняет барьеры между творческой идеей и готовым опубликованным роликом, позволяя генерировать вирусные форматы за считанные минуты.Использование проверенного пайплайна генерации в среде Rap Duo обеспечивает стабильное визуальное качество и превосходную звуковую согласованность. Применяя качественные входные снимки и точно формулируя смысловые запросы, команды получают возможность оперативно реагировать на тренды социальных платформ, поддерживая высокий темп публикации без раздувания производственного бюджета.
В долгосрочной перспективе внедрение подобных специализированных нейросетевых комплексов меняет саму структуру медиапроизводства. Вместо разделения задач между несколькими узкими специалистами один редактор может самостоятельно формировать полноценную линейку динамических музыкальных клипов, обеспечивая максимальный охват и вовлеченность аудитории.